-
储能智能运维升级:基于时序测点与工单数据的融合分析方法
随着大规模储能电站集群规模化投运,设备运维从传统的“人工巡检、故障消缺”模式,逐步转向数据驱动的状态检修模式。现阶段绝大多数储能场站已实现电池BMS全量时序测点采集,能够秒级采集电芯温度、电压、电流、压差、SOC、内阻等核心运行数据,实现设备状态的全天候监测。 但在实际运维落地中,“数据全覆盖、运维低精准”的矛盾愈发突出:海量监测告警刷屏、无效告警占比居高不下,真实隐患容易被淹没;运维工单仅留存闭环结果,缺少全过程运行数据支撑;故障处置依赖老师傅经验,问题复盘无量化依据,运维经验无法沉淀复用。究…
-
破除时序数据应用壁垒:新能源集团SCADA测点业务化落地解决方案
风电、光伏为主的新能源集团,场站侧依托SCADA系统实现设备运行全时段数据采集,单场站日均产生百万级高频时序测点,覆盖风机、逆变器、箱变等核心设备的温度、出力、振动、状态、电能质量等实时数据。海量高频数据的持续沉淀,让新能源集团拥有了体量巨大的设备原始数据资源。 但当前行业普遍存在“采得全、看不懂、用不上”的尴尬现状:SCADA原始测点以设备编码、技术参数、数值曲线为主,适配技术调试、设备监控场景,却完全脱离运维、经营人员的业务视角。业务人员无法从杂乱的时序数据中识别设备故障、发电损失、限电异常…
-
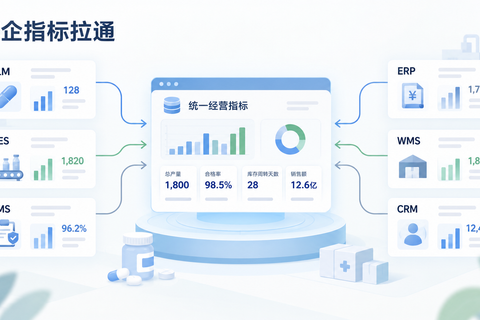
药企指标拉通:医药制造企业如何破解多系统指标口径分裂难题
医药制造数字化,指标口径分裂成为普遍痛点医药制造行业具备强监管、多业务域并行的特征。研发、生产制造、质量 QA/QC、供应链采购、仓储物流、销售营销、财务核算,各个业务域分别部署对应的信息化系统。PLM 研发管理系统、MES 生产制造执行系统、QMS 质量管理系统、WMS 仓储系统、CRM 销售系统、ERP 财务系统,多套系统分阶段采购上线,来自不同软件厂商。 随着医药企业规模扩张,集团管理层需要开展全维度经营分析:生产收得率、成品合格率、物料损耗、库存周转、销售达成、费用投入等核心指标。但大量…
-
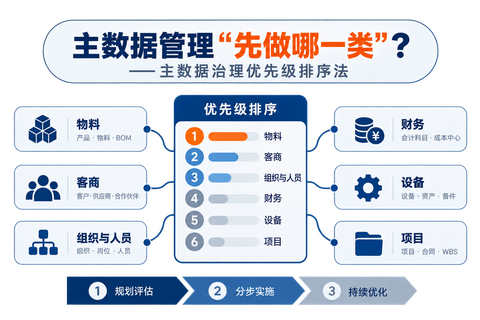
主数据管理 “先做哪一类”?—— 主数据治理优先级排序法
现象困境:主数据项目最大的坑,不是 “怎么做”,而是 “先做什么”绝大多数企业启动主数据管理项目,技术选型、工具评估往往会占用大量前期时间,但真正决定项目生死的,却是一个非常朴素的问题:企业内部物料、客商、组织人员、会计科目、设备、项目等十余类主数据,资源有限的前提下,究竟优先治理哪一类? 在大量企业数字化项目实践当中,我们能够观察到一类非常普遍的失败模式:项目组追求大而全,第一轮就希望把全部主数据类型一次性纳入治理范围。有限的预算、项目人力,被分散到多类主数据,每一类都浅尝辄止。治理完成之后,…
-
不做 “黑盒”:企业级 LLMOps 如何让大模型应用可观测、可迭代?
生成式大模型技术快速普及之后,大量企业开始尝试大模型业务应用,都会遇到一个共性现象:Demo 演示效果惊艳,落地生产环境却问题频发,难以持续迭代优化。 在测试环境,准备好干净的测试知识库,大模型问答效果可圈可点。但上线对接企业真实业务数据之后,就开始状况频出:答案时好时坏,偶发幻觉,遇到复杂业务问题输出错误结论。 一旦回答出错,研发人员很难定位根因:到底是知识库召回片段有问题?提示词设计不合理?Agent 规划逻辑缺陷?还是底层大模型本身的局限?整个推理链路像密闭的黑盒子,只能看到输入与最终输出…
-
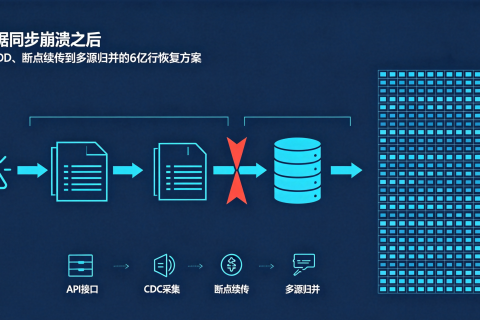
凌晨 2 点同步挂了,6 亿行数据要重跑?CDC + 断点续传 + 多源归并,破解数据同步三大难题
早上 9 点,运维群炸了。 “3 号实时同步任务凌晨 2:17 挂了,刚重启。” 消息一出,群里瞬间安静下来 —— 那是订单库到数仓的主链路,挂了 4 个多小时,丢了将近 2 个小时的增量数据。 点开任务日志:“网络超时,任务终止。”没有断点记录,没有自动续跑,重启后只能从上一个全量快照重新开始。 6 亿行订单数据,重新读一遍。 这已经是本月第三次了。 做数据同步的人对这种事不会陌生。实时数据同步这件事,说起来就是 “把数据从 A 搬到 B”,但真正做过的都知道 ——CDC、断点续传、多源归并这…
-
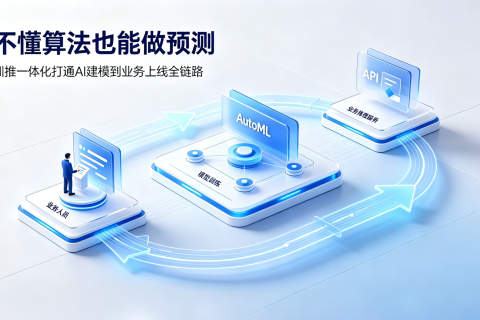
不懂算法也能做预测?训推一体化,打通 AI 建模到业务上线全链路
说个不少人都遇到过的真事儿。 某公司业务部门做年度预算时,想让数据同事帮忙预测明年销售额。大家心想这活儿不难,跑个时间序列模型就行。结果实际做起来才发现 ——数据要清洗、特征工程要做、模型要选、参数要调,训练完还要做适配部署。好不容易跑出来一个结果,业务部门说 “这个预测不太符合实际情况,能不能换一种方法试试”,然后从头再来。 折腾了三周,换了 5 种模型,最后领导拍脑袋定了一个数。 经历过的应该都懂:AI 建模这事儿,能不能别这么复杂? 一、为什么业务部门想用 AI,却总是用不上? 这其实不是…
-
数据分析师的”最后一公里”:如何用AI Copilot把报告从’看数’升级为’决策’?
上周五的月度经营分析会,又上演了熟悉的一幕。 销售总监说华东区销售额下降了 12%,市场总监说线索量明明增长了 15%,两个人各拿一份 Excel,口径不一样,数据对不上,谁也说服不了谁。最后老板拍桌子:“下周一之前,给我一份能说清楚问题在哪的报告。” 做了快十年数据分析,这种场景见过太多次了。报表做了无数张,数据堆了一座山,但离真正业务决策永远差一口气。 一、传统工作流下,数据分析到底卡在哪? 一个完整的业务数据分析项目,通常要经历需求对齐、数据准备、数据加工、模型分析、可视化呈现、业务解读六…
-
构建企业预测能力的捷径:当业务人员也能训练AI模型
在服务过数十家企业的数据能力建设后,我发现一个普遍存在的 “能力断层”: 企业的业务部门,问的是“下个季度哪个SKU会爆?”、“哪些客户可能流失?”……这些问题具有巨大的商业价值。然而,数据团队往往陷在取数、做报表的循环中。跨过“描述现状”走向“预测未来”的关键能力——机器学习建模——被牢牢锁在少数算法专家的手里。 这个断层导致了一个结果:最懂业务逻辑的人,无法直接参与到预测模型的构建中。 最近,我在深度评估一套技术方案时,接触到了一款值得关注的产品——助睿数智(Uniplore 系统)。这是一…
-
数据集成工具哪个好用?值得推荐的数据集成工具
在企业的数字化蓝图中,“消灭数据孤岛”是一项旷日持久且充满黑盒与陷阱的工程。数据集成(ETL/ELT)工具,就是这场工程技术攻坚战的核心武器。面对市场上数十种号称“万能连接器”的解决方案——从商业化的Informatica到开源Kettle,再到各类云原生Data Integration服务——到底哪个好用?有没有值得推荐的工具? 许多企业陷入典型的“选型陷阱”:工具买回来,才发现其架构是各类开源组件的拼凑,数据流跑到临界点就断;运维复杂,换个环境就得重新开发;最致命的是,遇到数据异常,要么流程…