
电商大促实时集成:高吞吐业务下,实时数据同步的工程取舍

业务场景描述
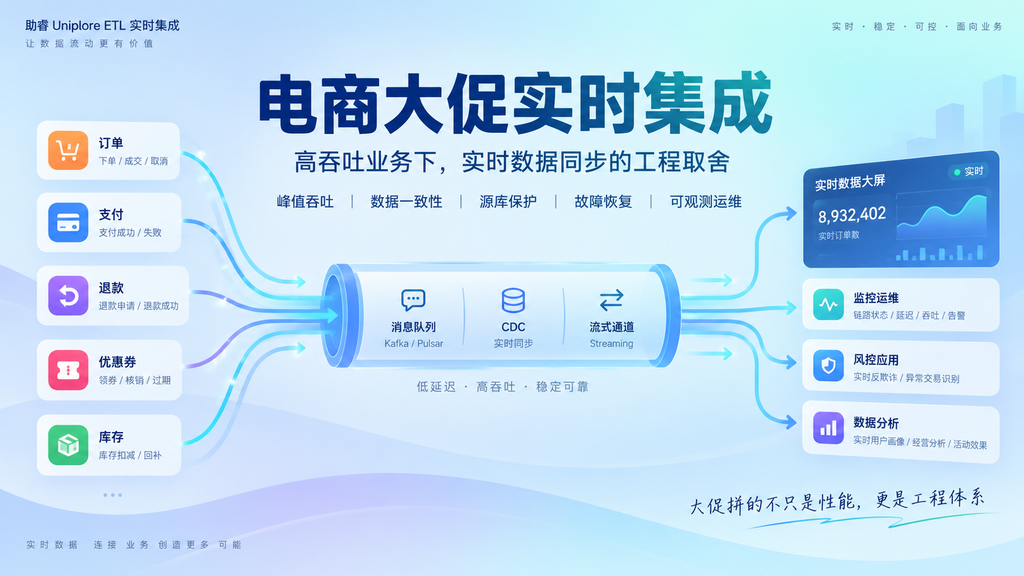
电商大促是对实时数据集成链路的极限压力测试。日常交易流量平稳,而大促活动期间,订单、支付、退款、优惠券核销、库存扣减等业务数据会在短时间内出现数十倍流量暴涨。业务侧需要实时数据支撑大屏交易看板、库存实时监控、营销风控、用户行为分析。
很多团队在 POC 演示阶段,实时同步链路运行十分顺滑,但真正进入大促实战,就会暴露出一系列棘手问题:任务延迟持续走高、消息队列堆积、任务异常重启出现数据重复或者丢失、源业务库被同步任务读取打垮,甚至大促期间整条实时链路直接失效。
不少团队把问题简单归因为引擎性能不足,不断提升服务器资源配置,但问题依旧反复出现。本质上,大促场景实时集成的挑战,不完全是 “跑的够快”,而是要同时兼顾峰值吞吐、数据一致性、源业务库保护、故障可恢复、可观测运维多重约束。单纯依靠堆硬件,无法解决工程设计层面的短板。
拆解工程层面多层矛盾
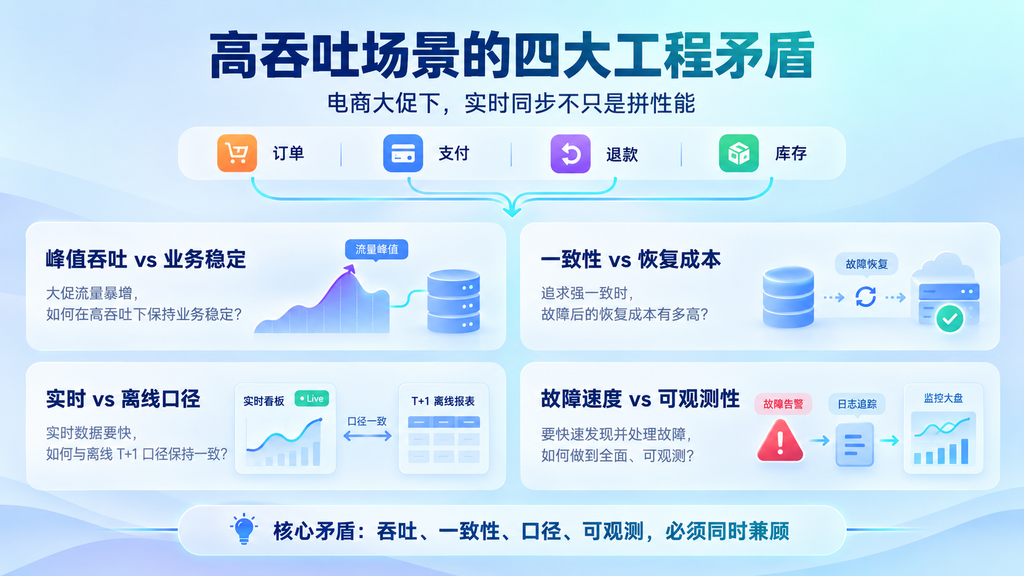
矛盾一:峰值流量冲击,吞吐能力与业务稳定性的矛盾
大促流量具备突发性、脉冲式特征。平时集群资源可以从容处理日常流量,但大促峰值瞬间流量陡增。如果同步组件是单节点架构,处理能力存在上限,流量突增后消费跟不上生产速度,数据开始堆积。 但无限制增加计算节点也会带来副作用:过多的数据库连接会对源端 MySQL、Oracle 业务库造成压力;同时节点越多,分布式环境下数据重复、事务错乱的发生概率也会提升。这里就形成第一层工程矛盾:想要更高吞吐,又不能无限制占用源库连接与系统资源。
矛盾二:故障重启,高一致性诉求和恢复成本之间的矛盾
网络抖动、集群资源抢占、GC 停顿,在大促期间属于高频发生的现象。一旦实时同步任务发生重启,就会面临恢复选择:依靠时间戳恢复,容易丢数据;全量重跑,产生海量重复数据;依赖 binlog 位点精确恢复,对工具底层实现有很高要求。 交易、库存、退款这类业务,属于强一致性场景,数据重复、丢失都会直接导致统计错误、库存计算错乱,对业务造成直接损失。而普通统计分析类场景,对重复容忍度相对更高。同一套实时链路,需要可以适配不同业务的一致性要求,这是第二层现实矛盾。
矛盾三:实时与离线两套链路,数据口径对齐的矛盾
大促场景下,一般会同时存在实时链路用于大屏实时展示,离线批处理链路用于 T+1 对账、财务统计。很多项目两套链路互相独立,采集逻辑、过滤条件不统一。最终出现实时大屏交易金额,和第二天离线统计结果对不上,业务侧产生质疑。维护两套独立链路,也会带来双倍开发、运维成本。
矛盾四:大促故障的可观测性矛盾
大促期间问题发生速度极快,如果缺少完整监控告警体系,往往是业务人员发现大屏数据不动了,运维才知道同步任务已经故障很久。故障发生之后,还需要花费大量时间排查:是源库 binlog 问题?消费阻塞?还是下游写入瓶颈?缺少全链路指标、日志、告警,故障排查窗口期被严重压缩。
实施全流程拆解
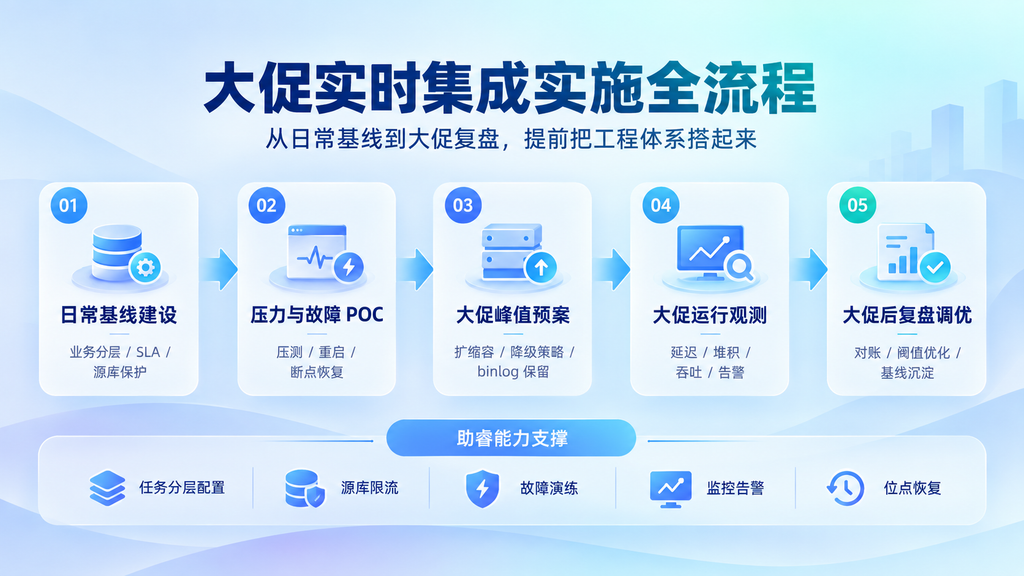
大促实时集成项目,不能等到临近大促才临时改造,完整实施分为:日常基线建设、压力与故障 POC 演练、大促峰值预案、大促运行观测、大促过后复盘调优五大环节。
环节一:日常基线建设
首先梳理业务分层:区分强一致性业务(订单、支付、库存、退款)与普通分析类业务(浏览、点击行为),定义每一类业务的一致性等级、延迟指标、SLA 要求。 针对不同业务分层,规划数据采集策略、消费语义、下游写入策略。同时完成源库访问管控,配置抽取限流、连接数上限,避免同步任务冲击线上业务。
很多企业在该阶段会遇到现实困难:现有实时同步工具,很难做到按业务分层差异化配置一致性策略;同时缺少源库访问保护机制,很容易出现同步任务抢占业务库资源。助睿 ETL 实时集成能力,正是针对这类痛点给出解决方案。可以针对不同业务任务独立配置消费语义、限流策略,强一致性业务启用 Exactly‑once,普通分析业务选用 At‑least‑once;同时内置源库访问保护,控制查询并发、连接上限,隔离同步任务对业务库的影响。
环节二:压力与故障 POC 演练
大促真正的考验不是正常流量,而是故障场景。POC 不能只跑平稳数据流,必须主动构造故障用例:网络中断、任务 kill 重启、流量压测暴涨、binlog 文件切换。验证三件核心事情:故障之后数据会不会丢、会不会重复;峰值下延迟变化;告警是否能够及时触发。
很多开源组件可以实现基础 CDC 能力,但要完整做完一整套故障模拟、压测演练,需要投入大量二次开发工作。借助 Uniplore 助睿可以直接复用内置的故障模拟测试能力,完成断点恢复、重启消费、流量压测验证,减少团队自研二次开发工作量。
环节三:大促峰值预案
提前评估峰值预估流量,完成集群扩缩容预案;配置任务水位告警阈值;制定降级策略:极端情况下,非核心分析类任务可以临时降优先级,保障交易、库存核心链路资源优先。同时确认 binlog 保留时长,防止大促高峰期 binlog 被提前清理,造成数据消费断点丢失。
环节四:大促运行观测
大促期间,依靠全链路监控面板,观测 binlog 读取速率、消费延迟、队列堆积、下游写入吞吐量、源库连接数。一旦指标触发阈值,告警主动推送运维人员,而不是等待业务反馈问题。
助睿内置完整的实时任务可观测体系,把 binlog 位点、消费延迟、队列堆积、源库连接占用全部纳入监控面板,多渠道告警通知。大促期间运维不需要登录多套组件后台,就可以完整掌握整条链路运行状态,缩短故障定位时间。
环节五:大促过后复盘调优
大促结束,对比实时结果和离线对账结果,核对数据一致性;复盘大促期间发生的异常事件,调整限流、并行度、告警阈值,沉淀为下一次大促的基线配置。
工程落地的 trade‑off:那些 demo 不会告诉你的取舍
做电商大促实时集成,不存在完美方案,每一项技术选择背后都伴随收益与代价,需要工程团队结合业务 SLA 做权衡。
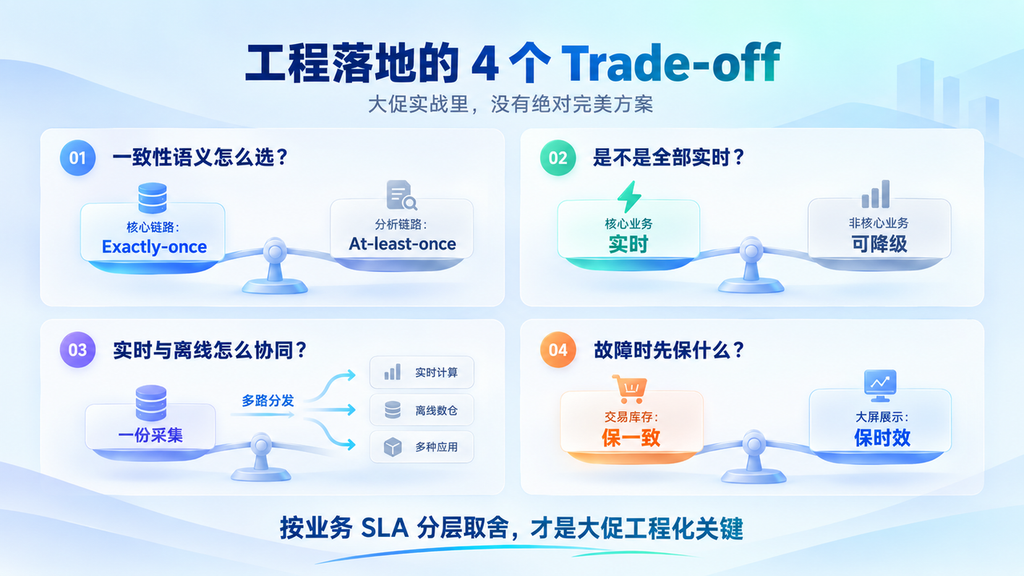
抉择一:为了绝对一致性,是否全部任务都开启 Exactly‑once 精确一次语义?
开启 Exactly‑once:收益是数据不丢不重,适配交易库存核心业务;代价是会增加计算资源消耗,带来少量延迟上涨。 全部任务都开启精确一次,会无谓消耗大量集群资源。更合理的做法是做业务分层:核心交易链路启用 Exactly‑once,普通用户行为分析类业务,接受 At‑least‑once,下游增加简单去重逻辑。
很多传统开源工具,很难做到任务粒度的语义灵活切换,要么全部开启、要么全部关闭。Uniplore 助睿支持单任务独立配置消费语义,允许同一套集群里面不同任务采用不同策略,正好适配这种分层取舍思路。
抉择二:大促峰值,要不要把所有数据全部走实时链路?
全部业务实时化:收益是全部指标低延迟;代价是峰值压力巨大,集群成本高,故障风险点变多。 折中取舍:核心交易、库存风控走实时链路;部分非关键统计业务,大促期间降级切换为离线增量同步,保障核心链路稳定性。这是大量成熟电商平台的实战选择。
抉择三:实时链路是否要和离线链路完全解耦,两套独立采集?
两套链路完全独立:开发简单互不影响,但会出现口径不一致,维护成本翻倍。 一套采集,分实时、离线两条消费下游:保证源头采集逻辑一致,口径对齐;但下游两个消费端任何一方故障,会对上游采集任务带来连锁影响。
助睿支持同一份 CDC 采集数据,分发到多个下游消费端,一份源头数据同时供给实时计算、离线数仓,从源头降低实时离线口径不一致风险,同时可以配置下游消费失败隔离策略,避免一端故障拖垮整条采集任务。
抉择四:故障发生,优先保数据一致性还是优先保延迟?
故障场景下,二者经常互相冲突。业务必须提前定义故障 SLA:对于交易库存,宁可延迟升高,也要保证数据不丢不重复;对于大屏展示类指标,可以接受短暂重复,优先恢复延迟。工具必须支持业务层面的策略选择,而不是写死固定处理逻辑。
选型的核心:工具适配工程方案,而不是方案适配工具
不少项目选型时本末倒置:看到工具具备大促相关宣传特性,反过来去改动自己的工程方案去适配工具能力。正确逻辑是,先梳理业务分层、SLA 指标、故障预案,再选择可以承接这套工程方案的工具。
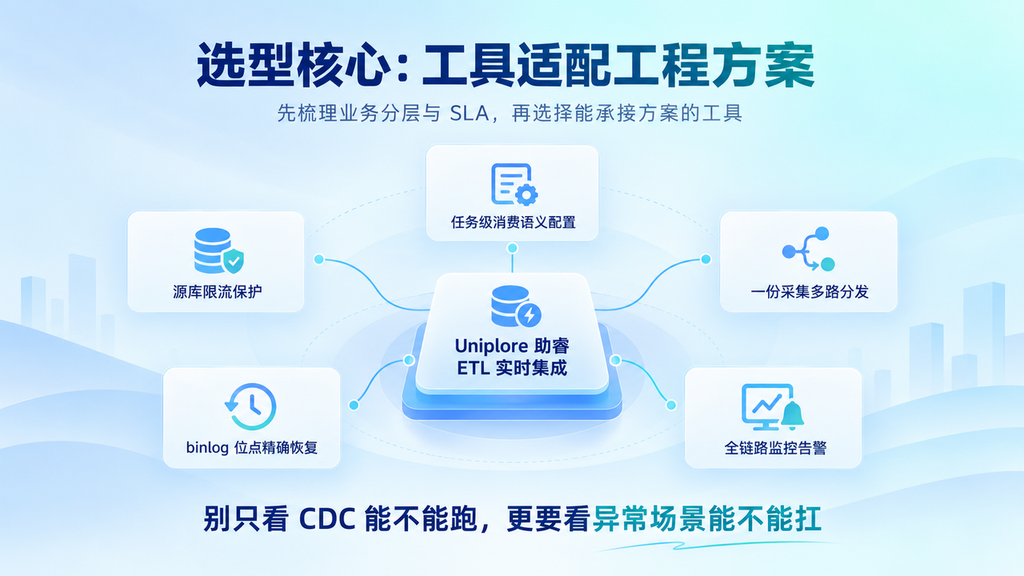
在电商大促实时集成这个场景,选型不能只看 “支持 CDC 实时同步” 这一项基础功能。需要重点审视:是否支持任务级别的消费语义配置;是否内置源库限流保护;是否具备完整可观测监控告警;是否支持一份采集多路分发;故障之后是否可以基于 binlog 位点精确恢复。
开源 Flink‑CDC 可以实现基础能力,但想要满足电商大促整套工程要求,还需要团队自行开发限流、多下游分发、完整监控告警、位点管理,研发成本高,同时对运维人员技术能力要求极高。 Uniplore 助睿 ETL 实时集成,把大促场景需要的整套工程能力全部产品化封装,业务团队可以直接基于平台落地上面整套分层、预案、故障处理的工程方案,不用从零做大量二次开发。但工具只是工程方案的载体,业务的 SLA 定义、业务分层、大促演练预案,依旧需要企业业务与架构团队自己输出,工具无法替代业务与架构设计。
落地总结
电商大促实时数据集成,本质是一套极限场景下的综合性工程体系,而不是单一组件性能问题。 POC 环境一切正常,不等于扛得住真实大促脉冲流量。业务分层设计、压测故障演练、峰值降级预案、完整可观测体系,缺一不可。 工具选择上优先看工程特性:断点恢复机制、差异化消费语义、源库访问防护、多下游分发、全链路监控告警,这些才是大促实战真正决定成败的关键点。不要被 demo 的流畅表现迷惑,真实业务的风险大多藏在异常场景之中。
发表回复
要发表评论,您必须先登录。