
AI分析报告看似完美却不敢用?核心问题不在大模型

一、问题的起点:一次未被验证的AI分析结果
去年年中,公司上线AI分析工具,为验证落地实用性,我们开展了一次真实业务场景测试:
- 测试问题:本月各区域销售情况如何,波动较大的区域请拆解原因?
- AI产出效果:仅用时3分钟,输出完整分析报告,包含销售趋势、同比环比拆解、业务优化建议
- 效率对比:传统人工取数分析,需2名数据人员耗时3天完成,AI实现百倍效率提升
原本计划将这份AI报告用于公司经营例会,却在预审阶段发现问题:业务部、财务部核对后,报告中东区销售数据与业务系统账面数据存在明显偏差。
为排查问题根源,我们推迟会议,组织IT、财务、业务多部门联合核查复盘。
二、问题复盘:AI分析出错的四层核心原因
本次AI数据偏差并非单一问题导致,而是多层问题叠加所致,逐层拆解如下:
- 第一层:多部门数据口径不统一 财务采用回款口径统计、业务采用签约口径统计、区域负责人自定义微调口径,三套数据、三套逻辑,天然存在数值差异。
- 第二层:数据表关联配置出错 业务标准关联键为客户编码,AI抽取数据时错误使用订单编号关联,直接导致全量聚合计算结果整体偏移。
- 第三层:数据过滤规则未完全生效 预设的脏数据过滤规则存在漏洞,测试数据、作废订单未被彻底剔除,违规参与统计分析。
- 第四层:核心指标无统一书面定义 销售额、营收等核心指标,各部门理解不一,企业无标准化、唯一的指标计算规范。
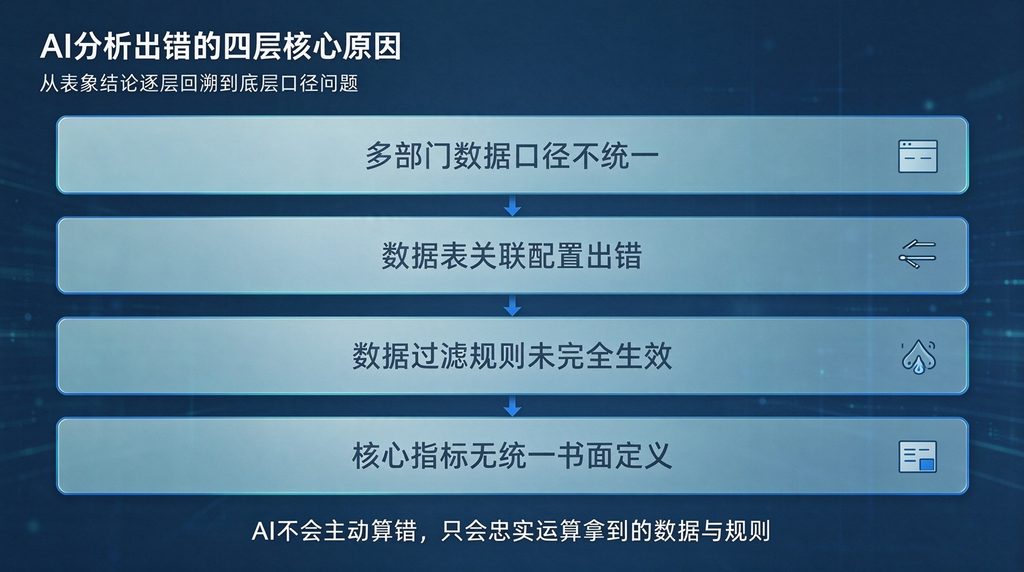
本次复盘得出核心结论:AI不会主动算错,只会忠实运算拿到的数据与规则;AI分析不可信,本质不是模型问题,而是底层数据、业务规则本身存在漏洞。
三、根源深挖:AI落地失效,暴露企业三类“数据债”
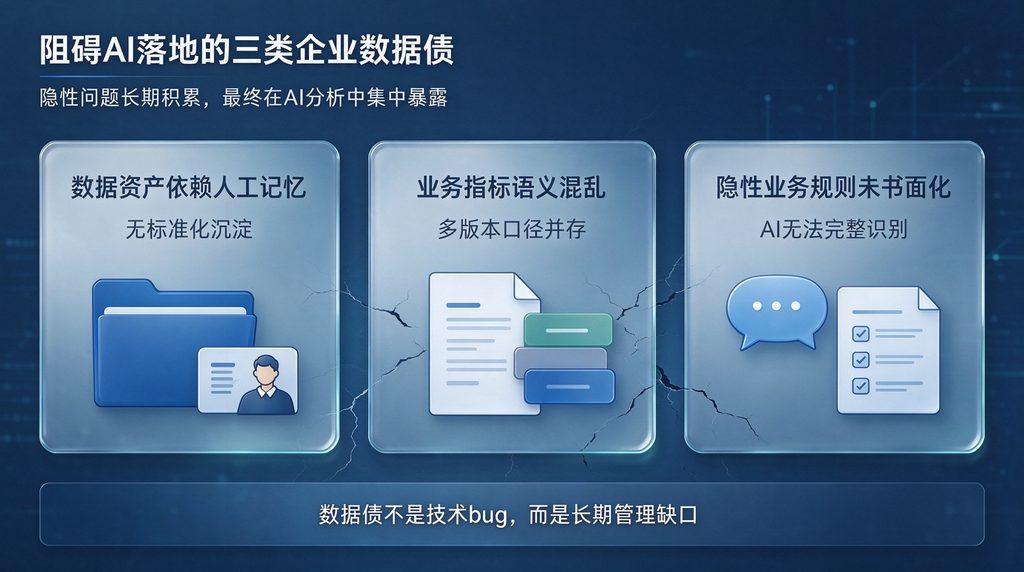
暂停AI应用后复盘发现,本次报错并非偶然,而是企业长期积累的“数据债”集中爆发,也是多数企业AI落地踩坑的核心原因:
- 数据债一:数据资产依赖人工记忆,无标准化沉淀 企业并存ERP、CRM、MES、财务系统及大量Excel台账,数据存储位置、归属、取数逻辑依赖老员工经验,无结构化资产清单,人员变动直接导致取数瘫痪、效率暴跌。
- 数据债二:业务指标语义混乱,多版本并存 营收、回款率、毛利率等高频指标,各部门自定义统计口径,系统各自为政,AI无法判别权威数据,只能随机取值,分析结果天然失真。
- 数据债三:隐性业务规则未书面化,AI无法识别 有效订单判定、脏数据剔除、客户分层等业务规则,仅留存于口头经验与零散文档,无统一规范。人工可以自主补全逻辑,但对AI而言,隐性规则等同于无规则。
四、应对路径:三步搭建标准化数据底座(工具+管理双落地)
想要AI分析精准可用、真正落地服务业务决策,必先筑牢企业数据底座。我们依托助睿(Uniplore)一站式数据智能服务产品,搭建轻量化、易落地、高适配的数据治理体系,整套落地流程分为核心三步:
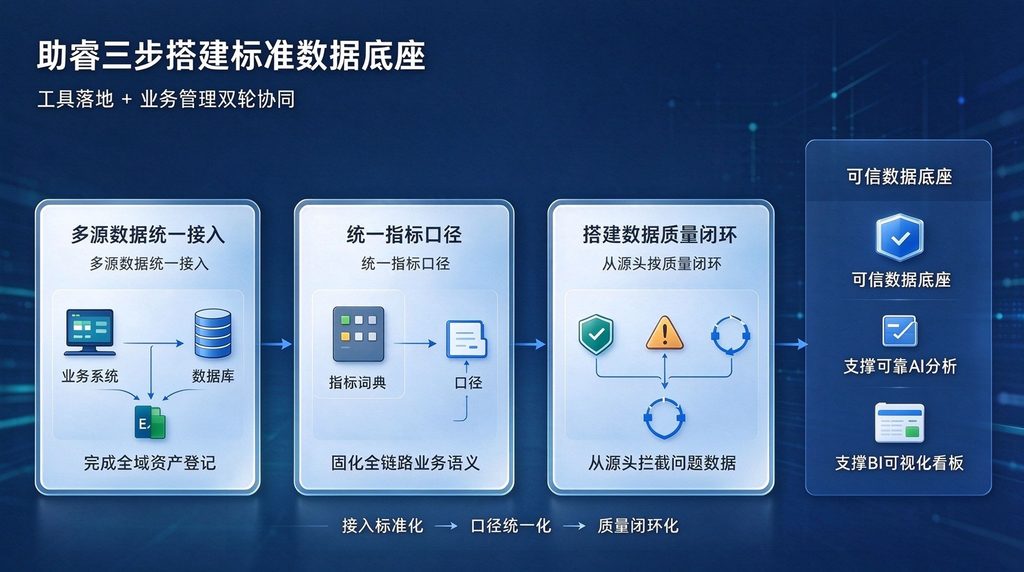
步骤一:多源数据统一接入,完成全域资产登记
核心目标:打通各系统数据孤岛,实现所有业务数据统一归集、可查可溯。
本阶段全程采用助睿数据集成与数据治理平台组合落地,无需改造、替换原有业务系统,完美适配企业新旧混杂的异构数据环境。
助睿核心接入能力:
- 全品类数据库兼容:支持MySQL、Oracle、SQL Server、PostgreSQL、DB2等主流关系型数据库,全覆盖企业业务系统后台数据。
- 离线台账全覆盖:兼容Excel、CSV、TXT等各类文件数据,解决企业零散手工台账归集难题。
- 国产化生态适配:支持国产数据库、数据仓库、API接口数据接入,满足自主可控合规要求。
- 零代码轻量化落地:摒弃传统ETL复杂脚本开发,全程可视化拖拽配置,数据抽取、转换、增量同步、定时调度均可自主完成,无需专职大数据开发,普通运维人员即可操作。
能力边界说明:工具可自动化完成全量数据接入、格式转换、定时同步与元数据登记工作。但权威数据源界定、治理范围划定、跨系统数据优先级判定,属于企业业务管理决策,需要各部门协同敲定,工具无法替代人工管理与业务沟通。
步骤二:统一指标口径,固化全链路业务语义
口径混乱是AI分析失真的核心元凶,也是本次治理的核心重点。我们联合财务、销售、生产多部门,统一十余个高频经营指标的计算规则,依托助睿DG完成标准化固化。
助睿数据治理核心能力:
- 指标全维度标准化归档:可录入指标计算逻辑、统计口径、归属部门、业务释义,终结口头化、碎片化定义,实现一指标一标准。
- 全链路口径联动:标准化指标一键同步至所有报表、数据分析、AI统计任务,彻底解决多页面数据打架问题。
- 变更智能感知预警:口径迭代变更时,系统自动识别所有下游依赖链路,一键通知全量使用方,规避变更导致的数据偏差。
能力边界说明:工具可高效完成口径固化、全局同步、变更预警等落地工作,但无法自动化解部门间的指标统计分歧。跨部门口径争议、业务规则修订,需要企业管理层统筹决策,工具仅负责承接共识、落地统一标准。
步骤三:搭建数据质量闭环,从源头拦截问题数据
依托助睿内置数据质量管控模块,搭建全流程校验、告警、整改、溯源闭环体系,杜绝脏数据流入AI分析链路。
核心管控能力:
- 多维度自动化校验:支持完整性、唯一性、合规性、跨系统一致性、数值合理性等多维度规则自定义校验。
- 全类型问题数据拦截:自动过滤测试数据、作废数据、空值数据、错配数据,保障数据源干净合规。
- 责任化整改闭环:异常数据自动告警、精准溯源、绑定责任人,形成「发现-派单-整改-复验-归档」完整流程。
- 全流程日志留存:所有数据问题、整改记录可追溯、可复盘,适配企业合规审计要求。
能力边界说明:系统可全自动拦截格式错误、空值、重复、跨系统不一致等结构化问题数据,但无法识别人工录入导致的业务逻辑错误,这类场景仍需业务人员人工复核兜底。数据治理并非一次性工程,需要长期迭代优化规则,持续适配业务变动。
五、效果复测:全栈底座落地,AI分析能力全面升级
本次治理我们同步搭配助睿可视化分析平台完成闭环落地:统一归集的标准化数据,可直接通过助睿平台搭建可视化报表、经营看板,实现数据可视化、业务透明化,同时为AI分析提供可信的数据数据源与权威统计模板。
治理完成后,我们复用初始测试需求复测AI分析效果,四大维度全面改善:
- 全域数据统一汇聚,数据源唯一权威,无需AI自主判别优先级;
- 核心指标口径全局唯一,彻底消除多版本数据冲突;
- 前置数据质量拦截,脏数据、异常数据无法进入分析链路;
- 数据全链路可溯源,数据波动可快速定位源头与责任人。
关键结论:本次复测全程未升级AI大模型、未优化算法逻辑,仅通过数据底座提质整改,就让AI分析从「表面完美、不可采信」升级为「口径统一、数据可信、业务可用」。这也印证了行业核心真相:企业AI分析的能力上限,永远取决于数据治理的落地下限。
六、行业落地建议:企业AI数据分析避坑指南
结合本次真实落地复盘,给所有布局AI数据分析的企业三条务实建议:
- 建议一:AI上线前,必做数据能力自测 若企业仍存在跨系统取数难、口径混乱、台账零散等问题,切勿盲目上线AI。AI只会加速输出错误结果,无法自动修复底层数据缺陷。
- 建议二:分清工具与管理的责任边界 工具负责「固化共识、落地规则、自动运维」,管理负责「统一口径、协调分歧、制定标准」,不要把管理难题全部寄托于工具解决。
- 建议三:接受数据治理是长期迭代工作 无需追求数据100%完美,真正的治理价值,是出现问题可追溯、可整改、可复盘,实现数据体系的持续优化。
七、结语:AI是能力放大器,不是错误修正器
本次项目复盘,让我们对企业AI数字化落地有了更清晰的认知:
- 优质数据底座,会让AI的效率优势无限放大,赋能业务决策;
- 残缺混乱的数据底座,会让AI的缺陷无限放大,产出虚假结论;
- AI只能优化效率,无法修正业务、数据、管理层面的底层问题。
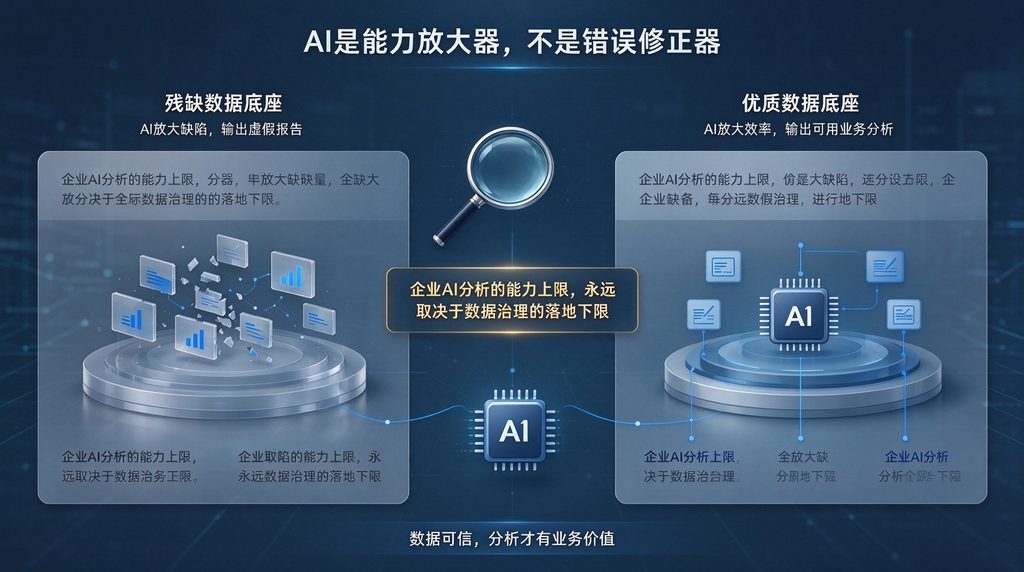
这也再次印证开篇的核心认知:AI只是能力放大器,而非错误修正器。企业智能化落地的最优姿态:依托助睿ETL、DG、BI全栈数据工具,轻量化筑牢标准化数据底座,用AI替代低效取数、自动生成分析初稿,最终保留人工复核与业务确权,实现技术赋能提效+业务严谨兜底的稳妥落地模式,从根源解决AI分析失真、不敢用的行业痛点。
发表回复
要发表评论,您必须先登录。